RAG и векторный поиск: как ИИ отвечает по данным сайта
Нейросеть не знает ваших товаров и правил доставки. RAG — способ дать ей нужный кусок данных прямо перед ответом. Разбираем, как это устроено и почему всё упирается в поиск.
Языковая модель много знает о мире, но ничего не знает о вашем сайте. Ни ассортимента, ни цен, ни условий возврата. Если спросить её напрямую, она ответит уверенно и придумает. RAG — способ дать модели нужные факты прямо перед ответом, чтобы она отвечала по ним, а не по памяти.
Что такое RAG простыми словами
RAG расшифровывается как retrieval-augmented generation — генерация с опорой на найденное. Работает в три шага:
- Найти. По вопросу человека система ищет в ваших данных несколько подходящих фрагментов: карточки, абзацы справки, строки документов.
- Подложить. Найденное вставляется в запрос к модели вместе с вопросом и инструкцией «отвечай только по этим данным».
- Ответить. Модель формулирует ответ своими словами, опираясь на подложенные фрагменты.
Модель не учится на ваших данных и не запоминает их. Она каждый раз читает свежую выдержку. Поэтому RAG в ИИ — это не обучение, а шпаргалка, которую собирают под каждый вопрос.
Почему без поиска RAG не работает
Первая буква в RAG — retrieval, поиск. Ответ не может быть лучше найденного: если в выдержку попали не те фрагменты, модель честно ответит по не тем фрагментам.
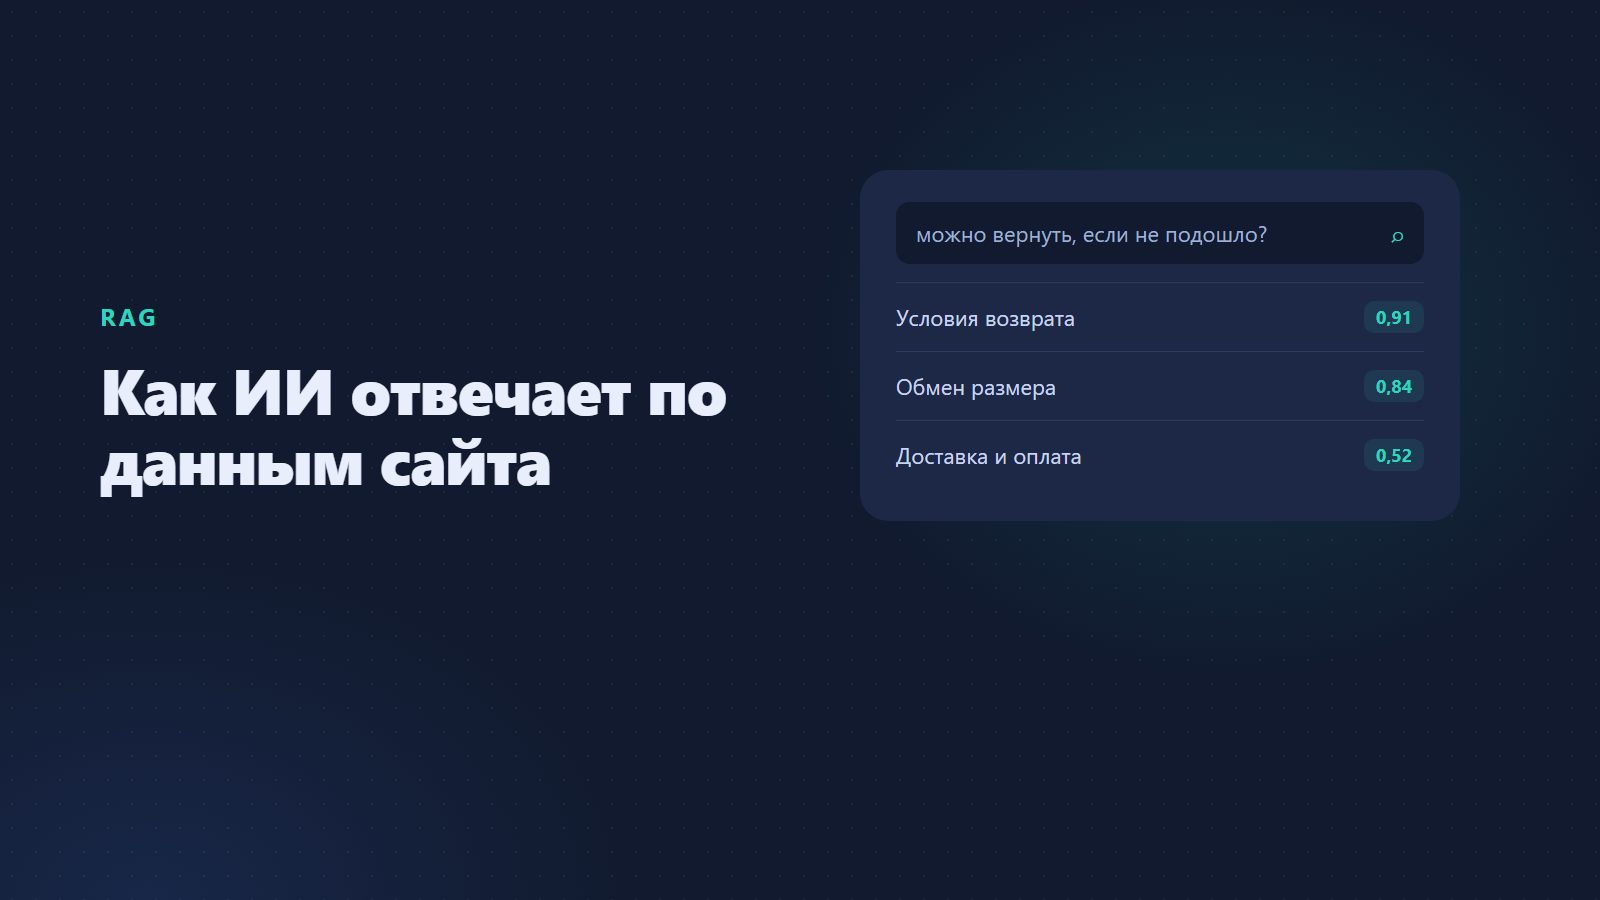
Люди задают вопросы своими словами. «Можно вернуть, если не подошло?» — а в справке раздел называется «Условия возврата товара надлежащего качества». Общих слов почти нет. Поиск по совпадению слов здесь промахивается, а векторный — находит, потому что сравнивает смысл.
Поэтому RAG векторный поиск — связка по умолчанию. Семантический поиск отвечает за то, что модель прочитает, а модель — за то, как это прозвучит.
Как устроена RAG-система
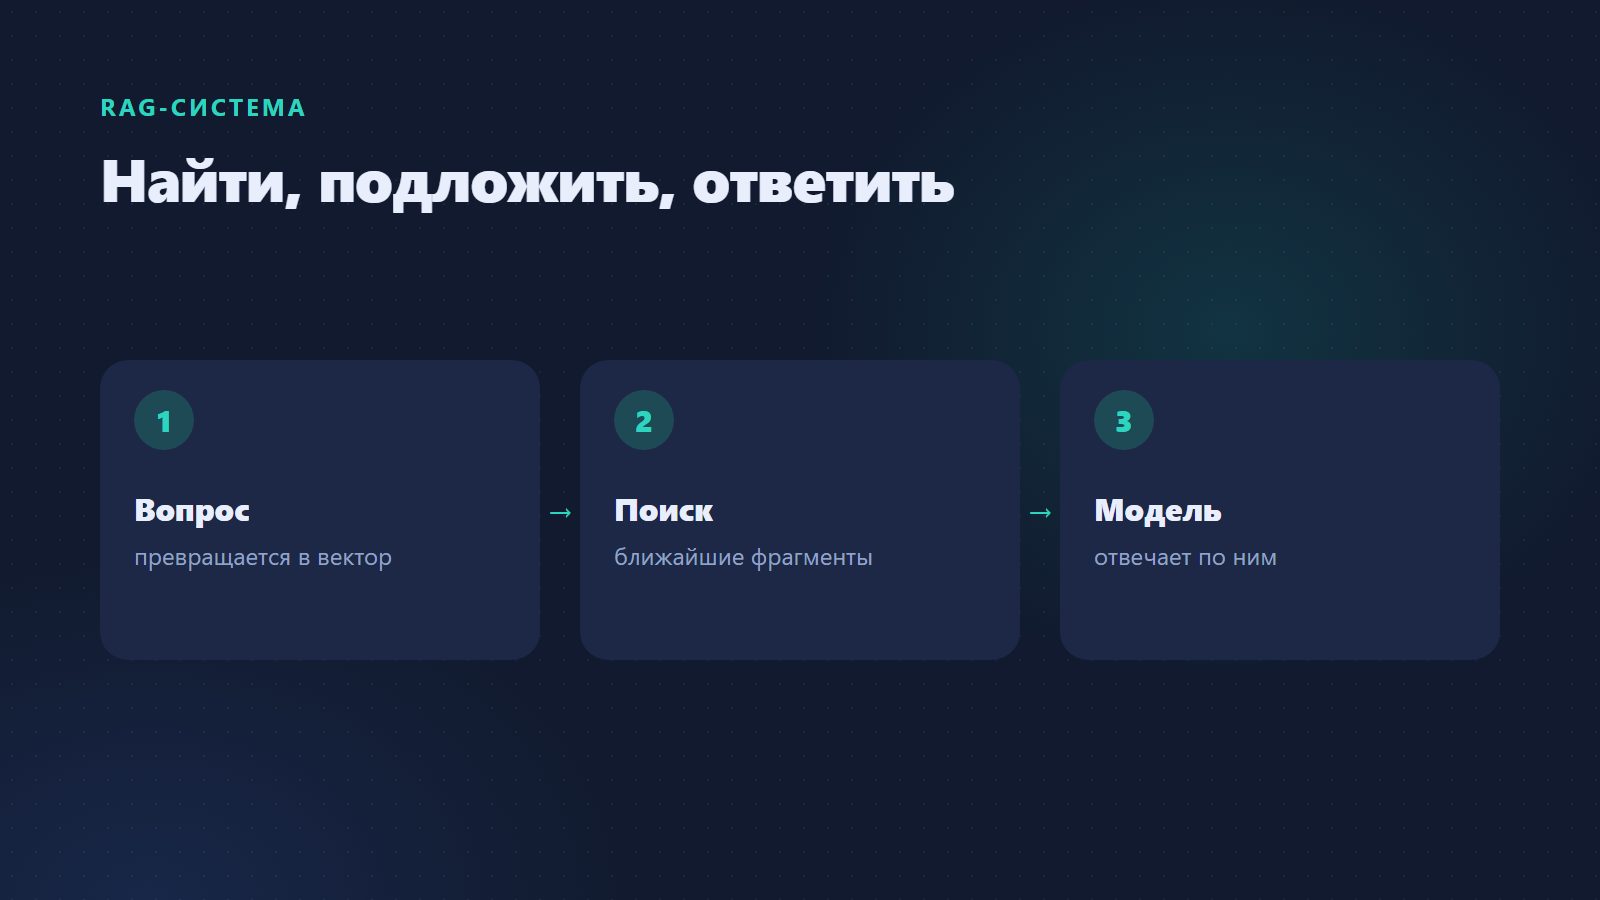
У RAG-системы две половины: подготовка данных и ответ на вопрос.
Подготовка, заранее:
- Сбор. Карточки каталога, страницы справки, документы, статьи.
- Нарезка. Длинный текст режется на фрагменты по смыслу: раздел, абзац, карточка целиком. Слишком крупный кусок размывает смысл, слишком мелкий теряет контекст.
- Эмбеддинги. Каждому фрагменту считается вектор.
- Хранение. Векторы и тексты кладутся в хранилище с метаданными: откуда фрагмент, когда обновлён, к какому разделу относится.
Ответ, в момент вопроса:
- вопрос превращается в вектор;
- поиск достаёт несколько ближайших фрагментов, фильтры отсекают лишнее;
- фрагменты и вопрос собираются в запрос к модели;
- модель отвечает и, в хорошей системе, указывает, откуда взят ответ.
Где хранить фрагменты
Векторная база данных для RAG нужна не всегда. На сотнях и тысячах фрагментов хватает обычной базы или расчёта в приложении. PostgreSQL с pgvector закрывает средние объёмы, отдельная векторная база — большие.
Подробный разбор вариантов — в статье векторный поиск в PostgreSQL, Elasticsearch и векторных БД.
Где RAG ошибается
- Нашлось не то. Самая частая причина плохого ответа. Лечится качеством поиска, а не сменой модели.
- Фрагмент оборван. Условие начинается в одном куске, а исключение — в следующем. Модель видит только начало.
- Устаревшие данные. Цена поменялась, а вектор и текст остались старыми. Нужен пересчёт при каждом изменении.
- Ответ из головы. Если подходящего фрагмента нет, модель может досочинить. Нужен порог: ниже него система отвечает «не знаю» или зовёт человека.
- Точные значения. Номер заказа, артикул, дата — это не смысл, а строка. Такие вопросы лучше уводить в точный поиск или в учётную систему.
Проверять RAG-систему надо на наборе реальных вопросов с известными правильными ответами. Смотреть отдельно, что нашёл поиск и что ответила модель: так понятно, какую половину чинить.
RAG на сайте: каталог, справка, документы
На сайте у RAG три разных источника, и устроены они по-разному.
- Каталог. Фрагмент — карточка целиком. Важны фильтры по наличию и цене: модель не должна советовать то, чего нет на складе.
- Справка и правила. Фрагмент — раздел или абзац. Важна свежесть: условия меняются, а старый ответ звучит так же уверенно.
- Документы. Договоры, инструкции, прайсы. Важна нарезка: таблицы и списки нельзя резать посередине.
Посетитель не разделяет эти источники. Он спрашивает сразу про товар, доставку и гарантию. Поэтому ассистент для сайта сначала понимает, о чём вопрос, и только потом ищет в нужном месте.
Собрать самому или подключить готовое
Прототип RAG собирается за вечер. Рабочая система — это ещё нарезка под разные типы данных, пересчёт при изменениях, пороги, передача оператору, проверка качества и логи с ответами, которые надо разбирать.
Если ассистент — ваш продукт, собирайте. Если это функция сайта, дешевле подключить готовое и заниматься данными, на которых он отвечает.
Вывод и следующий шаг
RAG — это поиск плюс модель. Модель отвечает за язык, поиск — за правду. Почти все ошибки RAG-системы начинаются с того, что поиск нашёл не то.
Следующий шаг: выпишите двадцать вопросов, которые вам чаще всего задают клиенты, и проверьте, на каждый ли есть ответ в данных сайта. Если ответа нет в данных, его не найдёт ни поиск, ни модель. Попробовать на своём сайте можно в демо за пять минут.
Частые вопросы
Чем RAG отличается от дообучения модели?
Дообучение меняет саму модель и требует пересборки при каждом изменении данных. RAG оставляет модель как есть и подкладывает свежие данные к каждому вопросу. Для сайта с меняющимися ценами и условиями RAG практичнее.
Обязательно ли нужна векторная база для RAG?
Нет. На небольших объёмах векторы хранятся в обычной базе. Отдельная векторная база нужна на миллионах фрагментов.
Какую модель брать для эмбеддингов?
Ту, что хорошо понимает язык ваших клиентов. Для русского текста стоит проверить несколько моделей на своих вопросах: разница в качестве поиска бывает заметнее разницы между языковыми моделями.
Как часто обновлять данные в RAG-системе?
При каждом изменении источника. Вектор считается по тексту: изменился текст — пересчитайте вектор, иначе поиск будет находить старую версию.
Почему RAG иногда отвечает не по документам?
Либо поиск не нашёл подходящий фрагмент и модель досочинила, либо инструкция разрешает ей отвечать по общим знаниям. Нужен порог близости и прямой запрет отвечать без опоры на данные.
Можно ли сделать RAG без программиста?
Прототип — да, с готовыми конструкторами. Рабочую систему на живом сайте без поддержки держать трудно: данные меняются, вопросы тоже.