
Векторный поиск в PostgreSQL, Elasticsearch и векторных БД: что выбрать
Где искать по векторам: в PostgreSQL с pgvector, в Elasticsearch или в отдельной векторной базе данных. Разбираем, от чего зависит выбор и когда отдельная база не нужна вовсе.
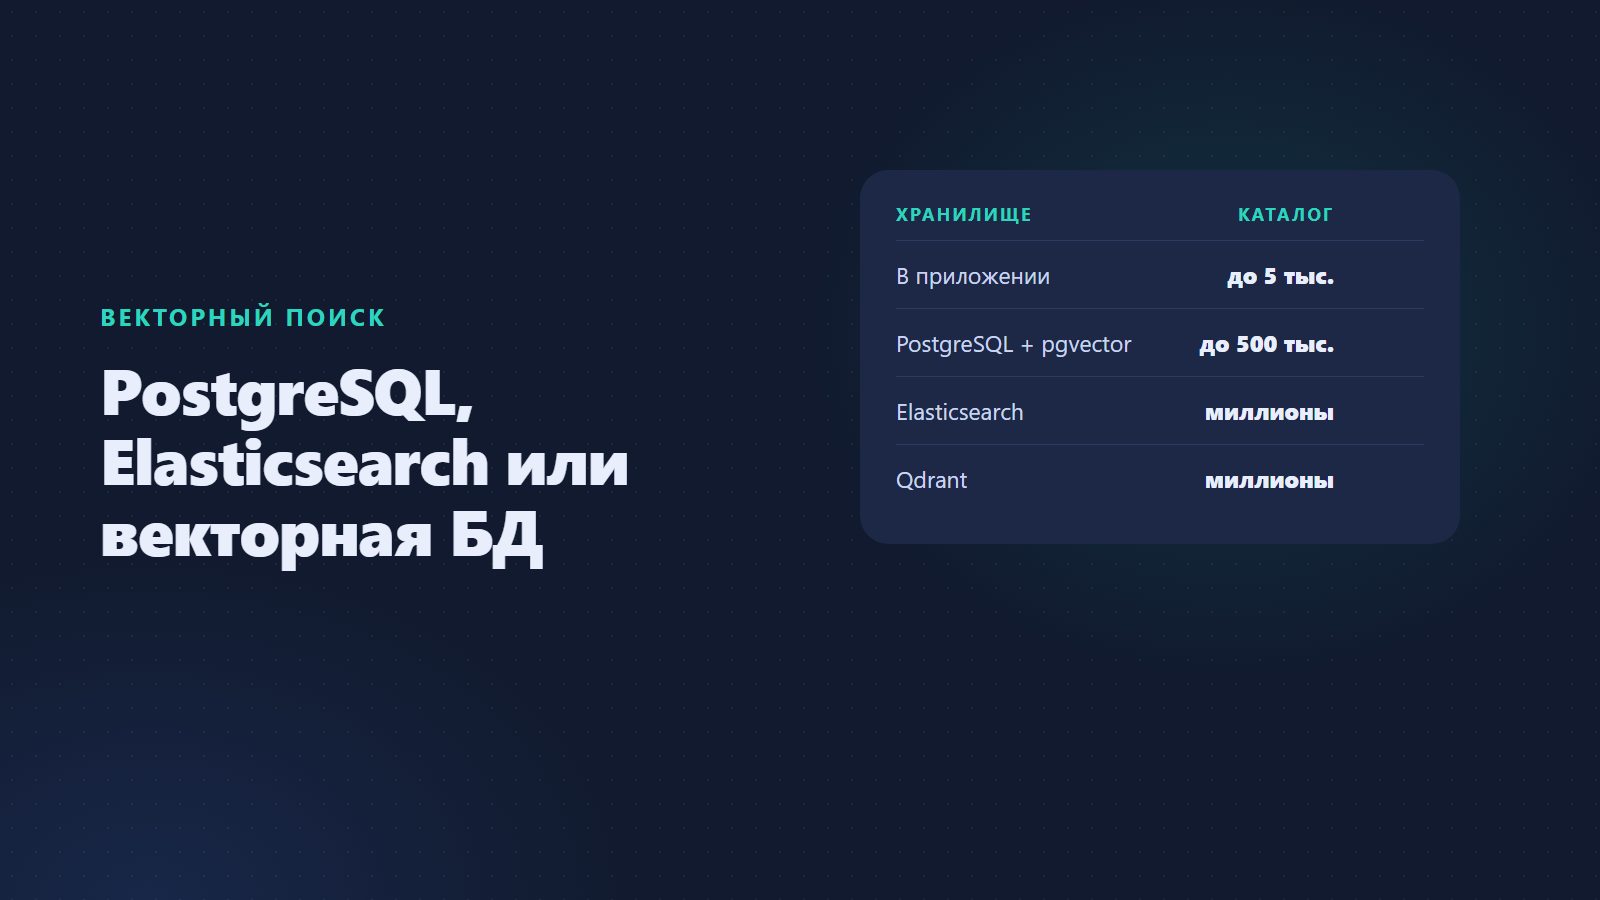
Векторы для каталога посчитаны. Теперь по ним надо искать: быстро, с фильтрами и без сбоев при обновлении. Мест для этого три: обычная база PostgreSQL с расширением, поисковый движок Elasticsearch и отдельная векторная база данных. Выбор зависит от размера каталога и от того, что у вас уже работает, а не от моды.
Что нужно хранилищу для векторного поиска
Поиск в векторной базе данных сводится к одной операции: найти записи, чьи векторы ближе всего к вектору запроса. Вокруг неё нужны ещё четыре вещи:
- Хранение. Вектор — это несколько сотен или тысяч чисел на запись. Их надо держать рядом с карточкой или ссылкой на неё.
- Поиск ближайших. Точный поиск сравнивает запрос со всеми записями подряд. Приближённый строит индекс и проверяет только часть, жертвуя долей точности ради скорости.
- Фильтры. Покупатель ищет «тёплую куртку» в наличии и дешевле десяти тысяч. Близость по смыслу — только половина задачи, вторая — жёсткие условия.
- Обновление. Карточки меняются каждый день. Хранилище должно принимать новые векторы без полной перестройки.
Точный поиск называют kNN, приближённый — ANN. Самый распространённый тип приближённого индекса — HNSW: граф, по которому поиск идёт от соседа к соседу.
Векторный поиск в PostgreSQL: pgvector
pgvector — расширение PostgreSQL, которое добавляет тип «вектор», операторы расстояния и индексы для быстрого поиска. Векторный поиск в бд становится обычным SQL-запросом: та же таблица, те же фильтры в WHERE, та же транзакция.
Сильные стороны:
- Не нужен отдельный сервис. Бэкапы, права и мониторинг уже настроены.
- Фильтр и близость в одном запросе. Наличие, цена и категория работают как всегда.
- Два типа индексов: HNSW для скорости и IVFFlat для экономии памяти и быстрой сборки.
Где начинаются ограничения:
- Индекс HNSW любит память. На сотнях тысяч векторов это заметно.
- Фильтр после индекса может срезать выдачу: индекс нашёл сорок ближайших, фильтр оставил три. Это лечится настройками и порядком условий, но об этом надо знать.
- Тяжёлый векторный поиск делит ресурсы с основной базой магазина.
Для каталога до сотен тысяч позиций, где PostgreSQL уже стоит, pgvector — первый кандидат.
Векторный поиск в Elasticsearch
В Elasticsearch векторы хранятся в поле типа dense_vector, а поиск ближайших идёт через kNN-запрос с индексом HNSW. Главный плюс — векторный поиск живёт рядом с полнотекстовым.
Сильные стороны:
- Гибридная выдача в одном запросе: точное совпадение слов плюс близость по смыслу. Артикул найдётся по строке, «что-нибудь для дачи» — по смыслу.
- Морфология, синонимы, опечатки и фасеты уже есть.
- Масштабируется на миллионы документов.
Слабые стороны:
- Это отдельный кластер, который надо держать, обновлять и кормить памятью.
- Порог входа выше: маппинги, анализаторы, настройка весов гибридной выдачи.
Elasticsearch векторный поиск оправдан, если движок у вас уже работает или каталог большой и полнотекстовый поиск всё равно нужен.
Векторные базы данных: Qdrant, Chroma, FAISS
Векторная база данных — хранилище, сделанное специально под поиск ближайших векторов. Обычная база хранит строки и ищет по условиям. Векторная хранит векторы и ищет по близости, а условия идут дополнением.
- Qdrant — отдельный сервер с хорошими фильтрами по полям записи. Подходит, когда векторный поиск — центральная функция продукта.
- Chroma — лёгкая база для прототипов и небольших RAG-систем. Запускается за минуты.
- FAISS — не база, а библиотека для поиска ближайших. Очень быстрая, но хранение, обновление и фильтры придётся писать самим.
Отдельная векторная база нужна, когда векторов миллионы, запросов много, а основная база не должна делить с ними ресурсы.
Сравнение по главным вопросам
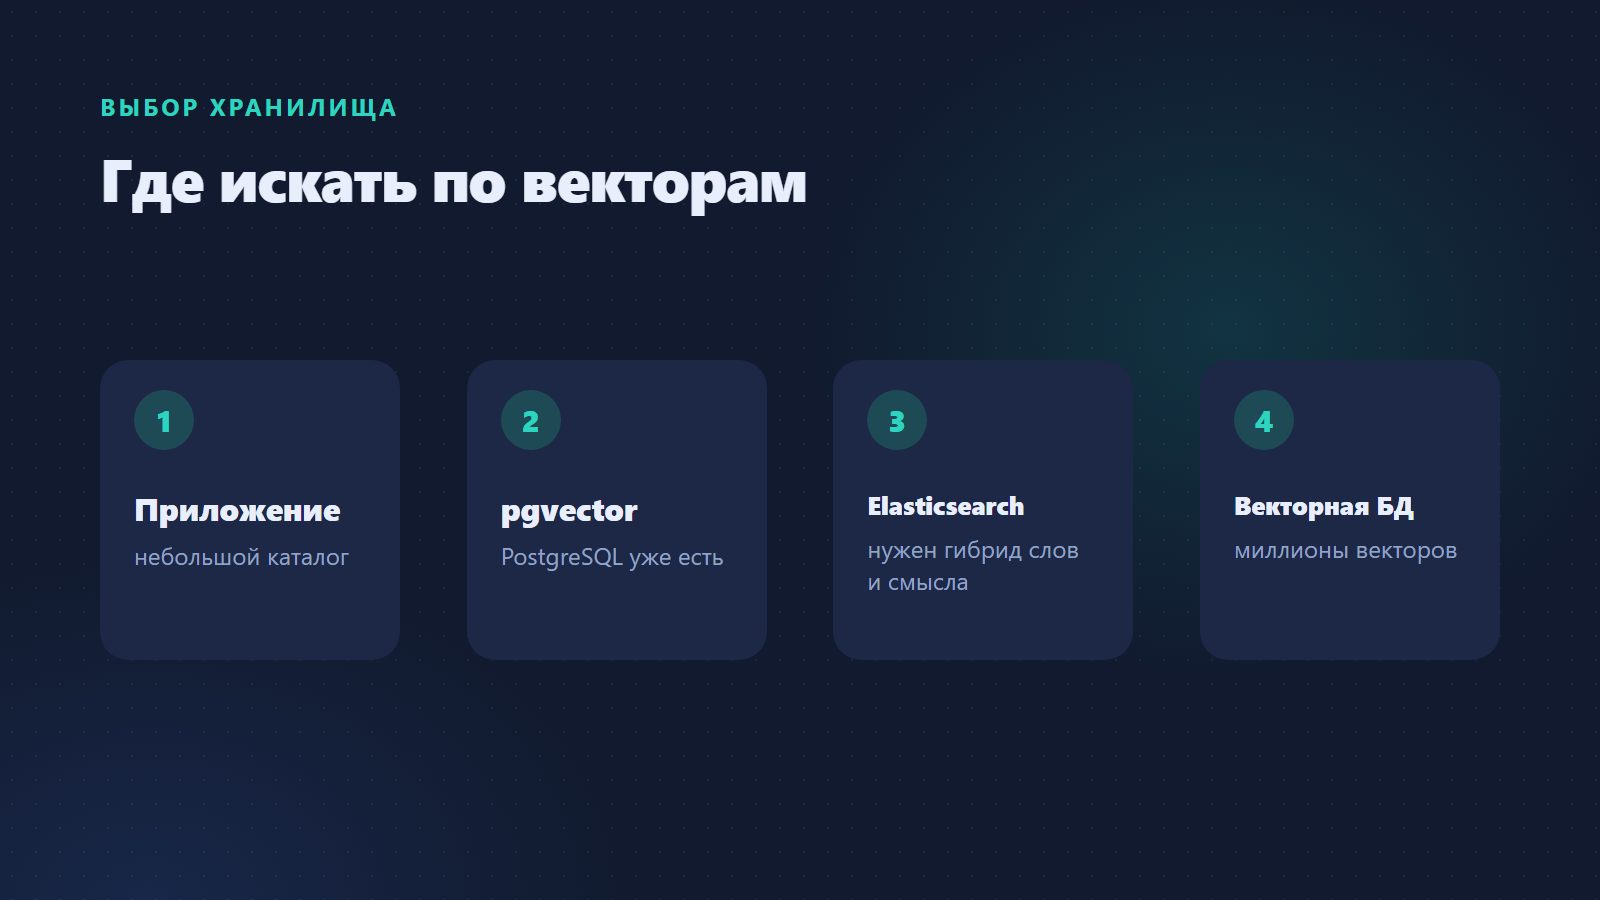
До нескольких тысяч карточек. Хватает расчёта прямо в приложении, без индексов. Отдельная база не нужна.
Десятки и сотни тысяч, PostgreSQL уже есть. pgvector: один сервис, фильтры в SQL.
Нужен гибрид слов и смысла, движок уже стоит. Elasticsearch.
Миллионы векторов, поиск — ядро продукта. Отдельная векторная база вроде Qdrant.
Прототип или RAG по документам. Chroma или FAISS, чтобы быстро проверить идею.
Ещё два вопроса решают выбор не хуже размера: кто будет поддерживать сервис и как часто меняются данные.
Когда отдельная база не нужна вовсе
Вектор карточки — несколько килобайт. Тысяча карточек — несколько мегабайт, которые помещаются в память приложения целиком. Сравнить запрос с каждой из них — доли секунды.
Мы в AISSE так и делаем на небольших каталогах: векторы хранятся в обычной базе компактной пачкой байт, близость считается в коде. Индекс нужен, когда карточек становится десятки тысяч. До этого он добавляет сервис, но не скорость.
Своё хранилище или готовый поиск
Хранилище — меньшая часть работы. Вокруг него придётся собрать:
- подготовку текста для векторов и их пересчёт при изменении карточек;
- разбор запроса: числа, цены, размеры уходят в фильтр, смысл — в вектор;
- ранжирование, которое смешивает точное совпадение и близость;
- порог, ниже которого поиск честно отвечает «такого нет»;
- проверку качества на наборе реальных запросов.
Если поиск — не ваш продукт, а функция магазина, дешевле подключить готовый поиск по каталогу и потратить время на сам каталог.
Вывод и следующий шаг
Нет лучшего хранилища вообще, есть подходящее под размер каталога. Маленькому хватает приложения, среднему — PostgreSQL с pgvector, большому с полнотекстовым поиском — Elasticsearch, огромному — отдельной векторной базы.
Следующий шаг: посчитайте карточки в каталоге и посмотрите, какая база у вас уже работает. В большинстве случаев ответ на этом и заканчивается. Посмотреть, как векторный поиск ведёт себя на вашем каталоге, можно в демо за пять минут.
Частые вопросы
Нужна ли векторная база данных для поиска по сайту?
Чаще нет. Для каталога до десятков тысяч позиций хватает обычной базы или расчёта в приложении. Отдельная база окупается на миллионах векторов.
pgvector или Qdrant: что выбрать?
Если PostgreSQL уже есть и векторов до сотен тысяч — pgvector. Если векторный поиск — главная нагрузка и нужны сложные фильтры на больших объёмах — Qdrant.
Можно ли делать векторный поиск в Elasticsearch без плагинов?
Да. Поле dense_vector и kNN-запрос входят в сам Elasticsearch, отдельные плагины не нужны.
Сколько векторов выдержит PostgreSQL?
Сотни тысяч — уверенно, при достатке памяти под индекс HNSW. Дальше всё зависит от железа и от того, сколько ещё нагрузки на этой базе.
Как совместить векторный поиск с фильтрами?
Жёсткие условия — цена, наличие, категория — идут фильтром, близость ранжирует то, что осталось. Следите, чтобы фильтр после индекса не оставлял пустую выдачу.
Что будет с индексом при смене модели эмбеддингов?
Векторы разных моделей несовместимы. При смене модели пересчитываются все векторы и перестраивается индекс. Подробно — в статье про эмбеддинги каталога.