llms.txt: что это такое, как создать файл и зачем он нужен сайту
Что такое llms.txt и чем он отличается от llms-full.txt, читают ли его нейросети на самом деле, как устроен файл, пример на живом сайте, как создать его вручную или генератором, что делать на Тильде и нужно ли прописывать его в robots.txt.
llms.txt — это текстовый файл в корне сайта, в котором коротко описано, что это за сайт и где на нём главное. Он написан в Markdown и адресован языковым моделям: вместо того чтобы разбирать меню, скрипты и рекламу, модель может прочитать одну страницу и сразу понять, куда идти за ответом.
Сделать такой файл несложно, но ожидать от него чудес не стоит. Ниже — что это за формат, насколько он работает на деле и как его создать.
Что такое llms.txt
Формат предложил Джереми Ховард, сооснователь Answer.AI, в сентябре 2024 года. Описание опубликовано на llmstxt.org. Идея простая: страницы сайтов делаются для людей и браузеров, а модели читать их неудобно — много лишнего, мало места в контексте. Нужна одна чистая страница-путеводитель.
Файл лежит по адресу сайт.ru/llms.txt и содержит:
- название сайта;
- короткое описание в одну-две фразы;
- списки ссылок на главные страницы с пояснением, что на каждой.
У формата есть спутник — llms-full.txt. Если llms.txt — оглавление со ссылками, то llms-full.txt — полный текст важных страниц в одном файле. Его удобно отдать модели целиком, например документацию продукта. Делать его необязательно: он нужен в основном сайтам с большой справкой или документацией.
Читают ли его нейросети
Честный ответ на осень 2026 года: подтверждений нет.
Ни OpenAI, ни Google, ни Яндекс публично не заявляли, что их поиск или ответы используют llms.txt при выборе источников. Представители Google прямо говорили, что их системы на этот файл не опираются. Роботы нейросетей приходят на сайт за обычными страницами, как и раньше.
Где файл всё-таки полезен:
- инструменты для разработчиков — некоторые помощники для программирования и сервисы документации умеют подтягивать llms.txt, когда пользователь даёт им ссылку на сайт;
- ручное использование — человек может скормить файл модели целиком и задавать вопросы по сайту;
- порядок на сайте — составляя файл, вы заодно решаете, какие страницы главные и как их коротко описать. Эти описания пригодятся и для обычных страниц.
Поэтому llms.txt — дешёвая и безвредная мелочь, но не способ попасть в ответы. Если сайт закрыт для роботов или тексты не отвечают на вопросы, файл не поможет. Что действительно влияет на выбор источников, разобрано в статье как нейросети выбирают источники.
Как устроен файл
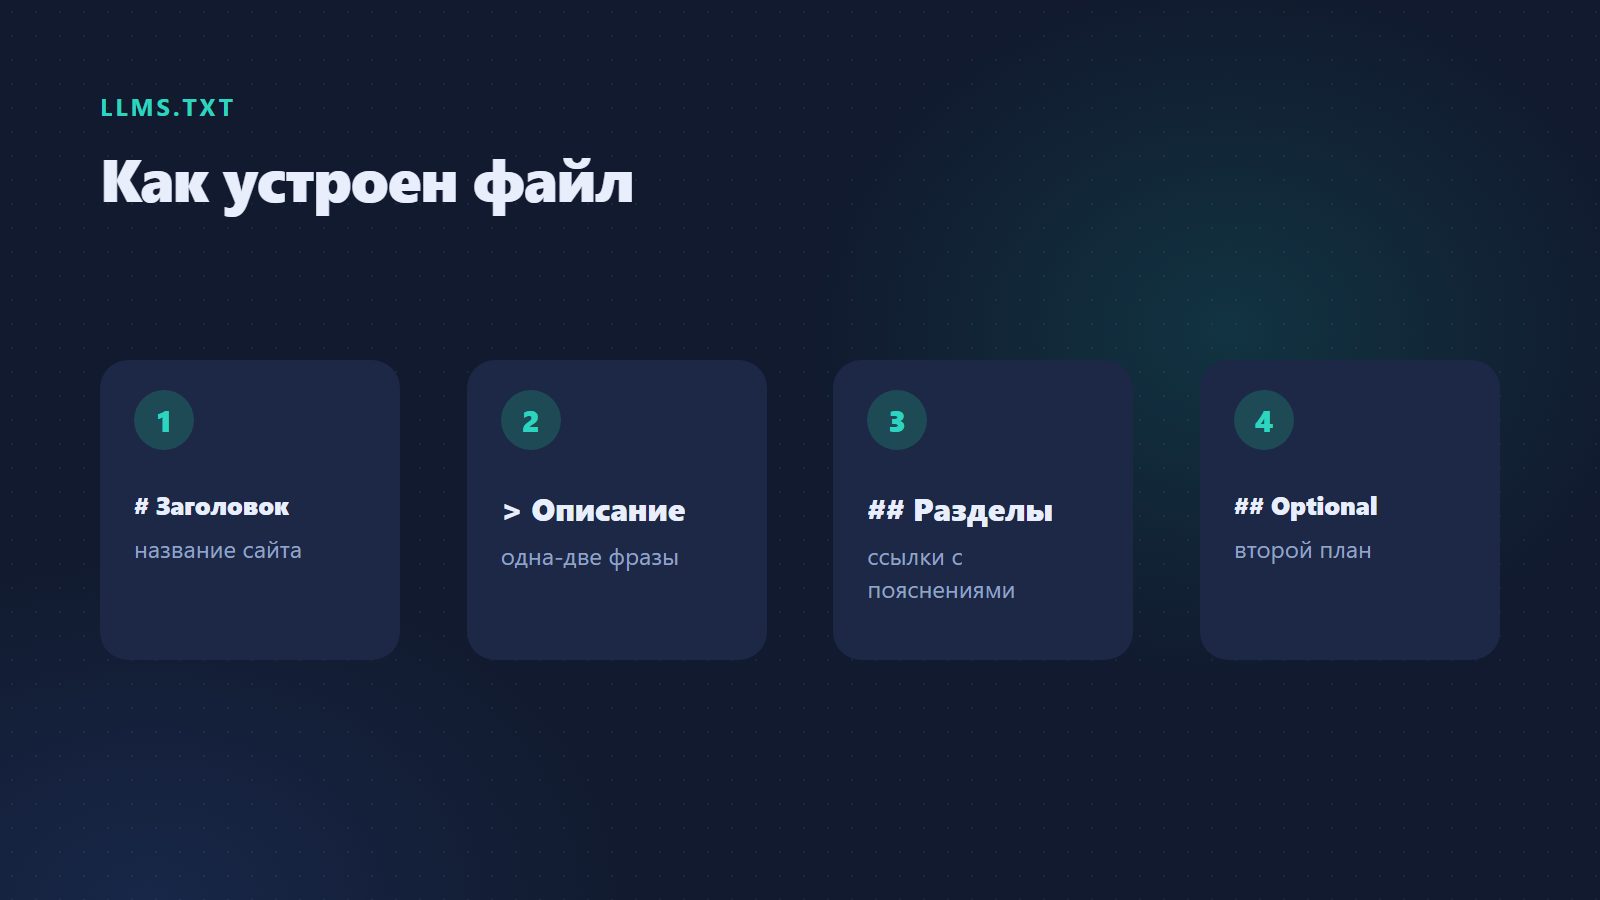
Формат строгий, но короткий. По порядку:
- Заголовок первого уровня — название сайта или проекта:
# Название. Единственный обязательный элемент. - Цитата — краткое описание, одна-две фразы, начинается с
>. - Обычный текст — при необходимости пара абзацев: важные уточнения, как пользоваться сайтом.
- Разделы второго уровня —
## Название раздела, а под ними списки ссылок в формате- [Название](адрес): пояснение. - Раздел «Optional» — ссылки второго плана, которые модель может пропустить, если места мало.
Всё. Никаких специальных тегов, HTML или JSON — только Markdown.
Пример файла llms.txt
Вот начало нашего собственного файла — aisse.ru/llms.txt:
# AISSE

> AISSE — поиск для сайтов, который понимает задачу посетителя,
> написанную своими словами, и подбирает товары, услуги или материалы
> с объяснением выбора.

Сервис подключается к каталогу или к статьям сайта, задаёт
уточняющий вопрос, когда без него не выбрать, и честно говорит,
если подходящего нет.

## Продукты

- [Умный поиск по каталогу](https://aisse.ru/products/poisk-po-katalogu): ...
- [Каталог для ИИ](https://aisse.ru/products/katalog-dlya-ii): ...

## О сервисе

- [Тарифы](https://aisse.ru/pricing): планы и что в них входит
- [Контакты](https://aisse.ru/contacts): почта, поддержка, реквизиты
На что обратить внимание:
- описание отвечает на вопрос «что это», а не рекламирует: без «лучший» и «уникальный»;
- у каждой ссылки есть пояснение — модель понимает, зачем туда идти, не открывая страницу;
- разделы по смыслу, а не по меню сайта: продукты, сведения о сервисе, справка;
- адреса полные, с доменом.
Для небольшого сайта хватит 10–30 ссылок. Наш файл длиннее, потому что в него входят статьи справки — по ним чаще всего задают вопросы.
Как создать файл: вручную и генератором
Вручную. Подходит для сайта на несколько десятков страниц.
- Откройте текстовый редактор и сохраните пустой файл
llms.txtв кодировке UTF-8. - Напишите заголовок с названием и описание в одну-две фразы.
- Выпишите 10–30 главных страниц: услуги, товарные разделы, цены, доставка, контакты, частые вопросы.
- Сгруппируйте их по разделам и добавьте к каждой короткое пояснение.
- Загрузите файл в корень сайта, чтобы он открывался по адресу
сайт.ru/llms.txt.
Генератором. Если страниц много, удобнее собрать черновик автоматически. Наш генератор llms.txt берёт sitemap сайта, собирает страницы с заголовками и описаниями и отдаёт готовый файл для скачивания. Черновик стоит просмотреть: убрать служебные страницы, сгруппировать остальное по смыслу и проверить пояснения.
Любой генератор работает с тем, что уже есть на сайте. Если у страниц пустые или одинаковые метаописания, такими же будут и пояснения в файле — тогда их лучше дописать руками.
llms.txt на Тильде
На Тильде нет штатного способа положить произвольный файл в корень сайта: страницы создаются в редакторе, а служебные файлы вроде robots.txt и sitemap.xml платформа формирует сама. Варианты такие:
- проверить настройки и справку Тильды — платформа развивается, и возможность может появиться;
- отдавать файл через прокси — если домен подключён через Cloudflare или свой сервер, запрос к
/llms.txtможно перехватить и отдать файл оттуда; нужна помощь технического специалиста; - не делать — раз нейросети не подтвердили чтение файла, для сайта на Тильде это не потеря. Время лучше потратить на тексты страниц.
Похожая ситуация на других конструкторах. На своём сервере, WordPress или 1С-Битрикс файл просто загружается в корневую папку сайта.
llms.txt и robots.txt: прописывать ли его
Нет. У robots.txt нет директивы для llms.txt, и прописывать его там не нужно. Это файлы с разными задачами:
- robots.txt говорит роботам, куда можно ходить и куда нельзя;
- llms.txt рассказывает, что на сайте главное.
Строка вида Llms: /llms.txt в robots.txt не входит ни в один стандарт, и роботы её проигнорируют. Важно другое: если в robots.txt закрыт доступ роботам нейросетей, они не прочитают ни llms.txt, ни остальные страницы. Проверить это поможет проверка видимости для ИИ — она же покажет, открывается ли ваш llms.txt.
Как проверить файл
Официального валидатора llms.txt нет: формат — это соглашение, а не стандарт с проверочным сервисом. Проверить файл можно так:
- Открыть в браузере
сайт.ru/llms.txt. Должен показаться текст, а не страница сайта с ошибкой 404 и не скачивание файла. - Проверить кодировку. Кириллица должна читаться, а не превращаться в набор символов.
- Сверить структуру: один заголовок
#в начале, описание через>, разделы через##, ссылки в формате[название](адрес): пояснение. - Пройти по ссылкам. Все адреса должны открываться — битая ссылка в путеводителе хуже, чем её отсутствие.
- Дать файл модели. Скопируйте его в ChatGPT или Алису и попросите рассказать, что это за сайт и где найти, например, условия доставки. Если ответ точный — файл понятен.
Наша проверка видимости для ИИ отмечает, есть ли на сайте llms.txt и отдаётся ли он как текст.
Вывод и следующий шаг
llms.txt — короткий путеводитель по сайту для языковых моделей. Сделать его можно за полчаса вручную или за минуту генератором. Но крупные нейросети не подтвердили, что используют его при выборе источников, поэтому это приятная мелочь, а не способ продвижения. Главное по-прежнему — открытый для роботов сайт и страницы, которые прямо отвечают на вопросы.
Если хотите сделать файл, начните с генератора llms.txt. А чтобы понять, что действительно влияет на попадание в ответы, прочитайте GEO-оптимизацию сайта: пошаговый план.
Частые вопросы
Обязателен ли llms.txt?
Нет. Это необязательный формат, и нейросети не требуют его от сайтов. Без него сайт может попадать в ответы, с ним — не попадать.
Поможет ли llms.txt попасть в ответы ChatGPT или Алисы?
Подтверждений нет. Ни OpenAI, ни Яндекс не заявляли, что используют файл при выборе источников. Влияют доступ роботов, индексация и качество страниц.
Чем llms.txt отличается от sitemap.xml?
Sitemap — полный список адресов для поисковых роботов, без пояснений. llms.txt — короткий отбор главных страниц с описанием каждой, написанный так, чтобы его легко понял и человек, и модель.
Где должен лежать файл?
В корне сайта: сайт.ru/llms.txt. В подпапке его никто не найдёт.
Нужен ли llms-full.txt?
Обычно нет. Он полезен сайтам с большой документацией или справкой, где модели удобно получить весь текст одним файлом.
Как часто обновлять llms.txt?
Когда меняются главные страницы: новые услуги, разделы, адреса. Если файл собран генератором, его проще пересобрать раз в несколько месяцев.